IA con Node.js y Ollama
Configura la conversación local, comandos de aplicaciones y respuestas autónomas.
1. Identifica las piezas del proyecto
El núcleo es src/main.mjs. Utiliza módulos separados: eventos.mjs para TikFinity, ia.mjs para Ollama, voz.mjs para Piper, avatar.mjs para VNyan y overlay.mjs para la capa HTML.
src/
├── main.mjs
├── eventos.mjs
├── ia.mjs
├── voz.mjs
├── avatar.mjs
├── overlay.mjs
├── aplicaciones.mjs
├── idle.mjs
└── conversacion.mjs
El puente requiere Node.js con WebSocket incorporado; la versión mínima indicada en su package.json es 22.4.0. No es necesario instalar un framework web ni crear una base de datos para ejecutar este proyecto.
2. Descarga y comprueba el modelo
ollama pull qwen2.5:3b
ollama list
.\scripts\probar_ollama.ps1
El modelo se carga desde Ollama en 127.0.0.1:11434. Si hay lentitud en GPU integrada, revisa la memoria, baja parámetros o selecciona un modelo compatible más ligero en la configuración, verificándolo antes.
"ollama": {
  "enabled": true,
  "baseUrl": "http://127.0.0.1:11434",
  "model": "qwen2.5:3b",
  "timeoutMs": 60000,
  "numPredict": 105
}
3. La respuesta de IA pasa por Ollama
En src/ia.mjs se realiza una petición a /api/chat con el prompt de la presentadora y la entrada del espectador tratada como texto no confiable. El código mantiene la respuesta corta y dispone de un saludo alternativo si no se ha habilitado el modelo.
const respuesta = await fetch("http://127.0.0.1:11434/api/chat", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "qwen2.5:3b",
    stream: false,
    messages: [
      { role: "system", content: "Eres Luna, presentadora virtual con IA." },
      { role: "user", content: "Saluda a los espectadores en español." }
    ]
  })
});
console.log((await respuesta.json()).message.content);4. Respuestas automáticas y comandos de aplicaciones
El archivo config.json contiene autoConversation.enabled=true y los valores de silencios e intervalos. En la captura de tu consola aparecen mensajes [AUTO] con temas espontáneos y respuestas [LUNA].
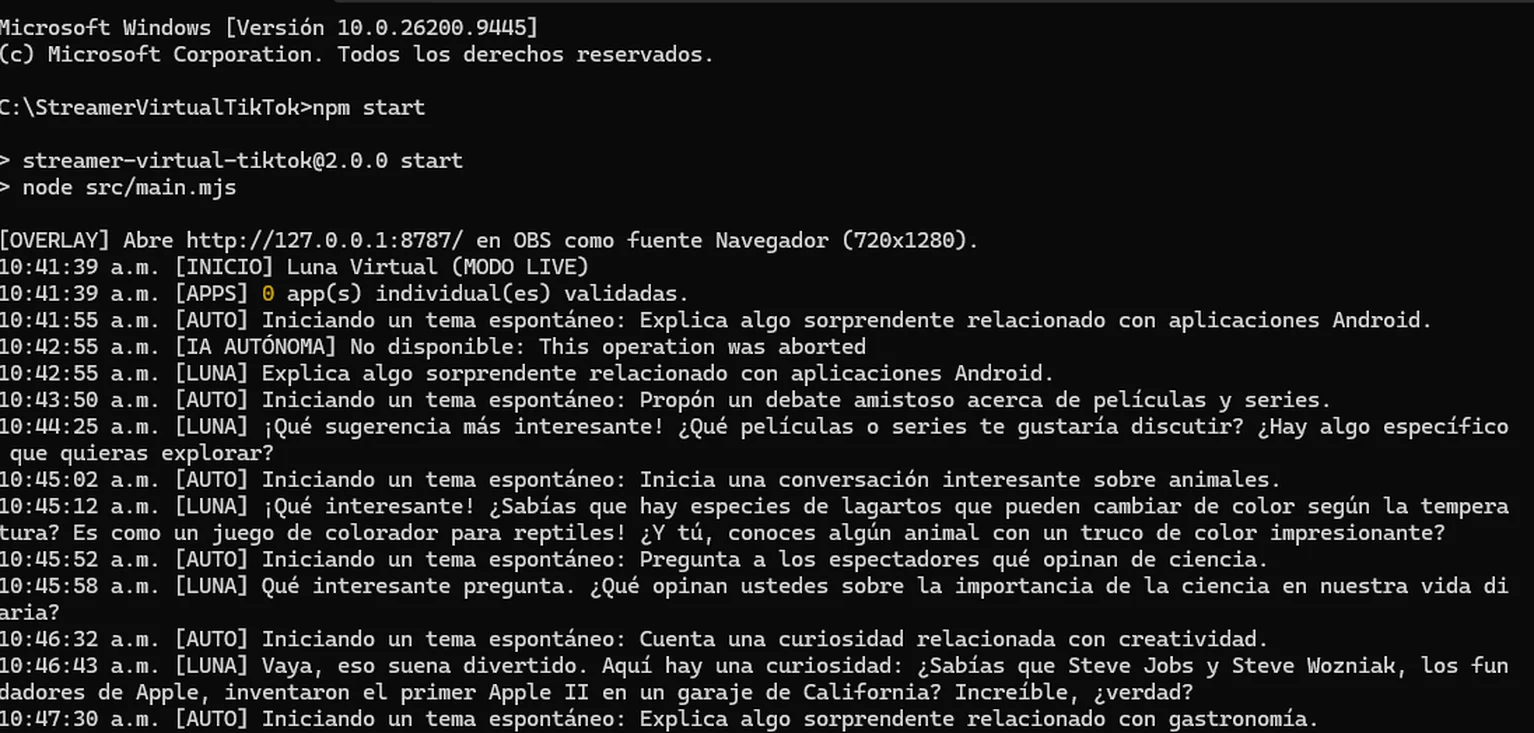
npm start. Se observan la dirección del overlay, el inicio del modo LIVE y la conversación autónoma.Descargar captura original PNG ↗Descargar versión optimizada WebP ↗- Comandos de chat
!app,!appso!aplicacionessolicitan información de las apps verificadas cuando llega el evento correspondiente. - En tu archivo
data/apps.jsondel ZIP aparecen 0 apps cargadas (es[]); la consola confirma0 app(s) individual(es) validadas. - El perfil de desarrollador apunta a la URL oficial de AppInitDev; no se deben inventar productos ni recomendar aplicaciones no presentes en el catálogo verificado.
- La intervención autónoma genera temas para romper el silencio, pero no debe fingir comentarios de espectadores.
5. Ejecuta el modo demostración sin abrir TikTok
cd C:\StreamerVirtualTikTok
npm run check
npm test
npm run demo
En modo demo el puente no se conecta a TikFinity y permite simular eventos desde la terminal (según las instrucciones del programa). Revisa la ayuda del ZIP para los comandos de demo. En este modo el proyecto no ejecuta la voz Piper real; pruébala con probar_voz.ps1.