Nivel 5 · Formación técnica avanzada · 54–60

A2E Master
Ingeniería de IA generativa

Una continuación especializada para quienes quieren comprender los modelos por dentro, controlar las condiciones, entrenar con rigor, planificar cámaras 3D, medir continuidad temporal y diseñar sistemas de producción. No es otra colección de prompts: es un manual de ingeniería.

7capítulos nuevos
54–60numeración continua
100%guía HTML local
Cómo estudiar este nivel: comienza en el 54 si ya completaste Pro-Experto Plus (39–53). Cada capítulo incluye fundamentos, un caso de producción, un laboratorio técnico y lecturas verificables. Las fórmulas son simplificaciones didácticas; los motores comerciales pueden tener implementaciones diferentes.
Capítulo 54 · A2E Master

Arquitecturas generativas: de la difusión latente al Flow Matching

Aprende a razonar sobre el modelo, no solo a usar su interfaz.

Competencia al terminar: Poder identificar el papel del codificador, el espacio latente, la red generativa, el muestreador y el decodificador; explicar por qué un modelo puede obedecer el prompt pero fallar en identidad o geometría.

Mapa de procesamiento

En una canalización moderna de texto a imagen, el texto se transforma en representaciones numéricas mediante uno o varios codificadores. El generador predice cómo transformar ruido o una representación perturbada en una representación visual coherente. En muchos sistemas, esto ocurre en un espacio latente, de menor resolución que la imagen final. Un decodificador —frecuentemente el de un autoencoder— transforma la representación latente a píxeles. No todos los modelos comerciales utilizan la misma arquitectura ni exponen estas etapas al usuario.

Diffusion Transformer y atención multimodal

Los modelos tipo Diffusion Transformer (DiT) tratan los elementos latentes como tokens que pueden intercambiar información mediante atención. La familia MMDiT, descrita en la investigación de Stable Diffusion 3, emplea representaciones de texto e imagen con pesos separados e intercambio bidireccional. La implicación es técnica: una descripción correcta no garantiza una anatomía correcta, porque la alineación entre palabras, regiones y relaciones espaciales no equivale a una simulación física de la escena.

Flow Matching y trayectoria de generación

Flow matching aprende un campo vectorial que transporta una distribución inicial a otra. Una trayectoria lineal pedagógica entre ruido ε y una muestra latente z₁ puede escribirse como z(t) = (1 − t)·ε + t·z₁; el modelo aprende a aproximar una velocidad vθ(z,t,c) dependiente de la condición c. Esta simplificación sirve para entender el mecanismo: no implica que todos los sistemas implementen exactamente esta trayectoria ni que menos pasos siempre produzcan mejor calidad.

Cómo diseñar un experimento científico

Mantén prompt, referencia, relación de aspecto y semilla constantes cuando sean compatibles, y modifica una sola variable: por ejemplo, número de pasos o método de muestreo. Registra cuatro resultados: adherencia semántica, consistencia de identidad, artefactos y tiempo de ejecución. No compares modelos diferentes suponiendo que el número de pasos es equivalente: sus escalas y planificadores pueden no ser comparables.

Caso de producción: Un mismo personaje sale bien en retrato pero falla al alejar la cámara. No se corrige automáticamente agregando “8K”. Hay que verificar si la representación de identidad pesa menos cuando ocupa pocos píxeles, si la referencia se aplicó y si el modelo puede resolver detalles de cuerpo completo.

Laboratorio técnico del capítulo

  1. Dibuja tu canalización real: referencia → codificación → condición → generador → decodificación → posproducción.
  2. Documenta qué etapas puedes controlar en A2E y cuáles permanecen ocultas.
  3. Haz tres variantes donde cambies una variable por vez y anota las diferencias; si la plataforma no expone la variable, marca “no disponible”.

Entregable: un documento de decisiones técnicas y evidencias; no basta con una imagen bonita.
Límite importante: No deduzcas la arquitectura interna de un servicio cerrado a partir de su interfaz; usa documentación pública o marca la información como desconocida.
Capítulo 55 · A2E Master

Control del condicionamiento: atención, CFG y conflictos entre referencias

Controla prioridades y restricciones en vez de acumular adjetivos.

Competencia al terminar: Diseñar una especificación multimodal que separe identidad, contenido, geometría, apariencia e iluminación, y diagnosticar cuándo las condiciones entran en conflicto.

El problema de las señales incompatibles

Un prompt puede exigir “rostro idéntico” mientras otra imagen impone una cabeza girada con iluminación completamente distinta; un mapa de profundidad puede exigir una posición incompatible con la referencia de pose. El generador intenta satisfacer condiciones que no siempre pueden cumplirse simultáneamente. Debes asignar a cada referencia una responsabilidad: identidad, encuadre, pose, profundidad, estilo o color, sin asumir que cualquier servicio permite modularlas por separado.

Classifier-Free Guidance (CFG)

En variantes que lo utilizan, CFG combina una predicción sin condición y otra condicionada. Una forma simplificada es predicción = u + s·(c − u), donde u es la predicción incondicional, c la condicionada y s la escala. Al aumentar s se puede reforzar la adherencia al prompt, pero también introducir saturación, formas extrañas o reducción de diversidad. No existe un valor universal recomendado ni todas las plataformas exponen CFG.

Control espacial y control semántico

El texto comunica conceptos: “persona sentada frente a ventana”. La profundidad comunica relaciones aproximadas de cercanía; una pose comunica articulaciones; un borde comunica contornos; una máscara comunica la región editable. La atención cruzada enlaza representaciones de texto e imagen, pero no equivale a un sistema de restricciones matemáticas duras. Un flujo profesional usa una jerarquía de condiciones y valida el resultado contra cada una.

Matriz de prioridad

Para una campaña de influencer, define una matriz: identidad = crítica, pose = alta, vestuario = media, fondo = flexible. Ante un conflicto, modifica primero la condición menos importante. Guarda las razones de cada cambio. Si se permite modificar pesos de adaptadores o guías, haz un barrido controlado: no cambies referencia, peso y seed a la vez porque no sabrás qué causó la mejora.

Caso de producción: Necesitas la misma persona en una oficina, pero el modelo cambia el color de ojos al cambiar de iluminación. Conserva la referencia facial de la escena maestra, cambia únicamente el escenario, y revisa el rostro en un recorte de igual escala antes de aceptar la escena.

Laboratorio técnico del capítulo

  1. Redacta cinco invariantes del personaje y cinco atributos variables.
  2. Crea una matriz “fuente de control → propiedad controlada → prioridad → criterio de aceptación”.
  3. Realiza un ensayo con un único conflicto intencional y escribe cómo lo resolviste.

Entregable: un documento de decisiones técnicas y evidencias; no basta con una imagen bonita.
Límite importante: Los pesos y rangos efectivos cambian entre motores. No copies valores numéricos de un modelo a otro sin pruebas.
Capítulo 56 · A2E Master

Ingeniería de datasets: generalización, leakage y entrenamiento reproducible

Una buena identidad sintética empieza con datos medibles y permisos claros.

Competencia al terminar: Diseñar un conjunto de entrenamiento de un personaje virtual, evitar memorizar fotografías y crear evaluaciones fuera de muestra que midan generalización real.

Por qué más fotografías pueden empeorar el entrenamiento

Un dataset con 100 imágenes casi idénticas puede aportar menos diversidad que 25 imágenes con variación controlada. El problema no es solo la cantidad, sino cobertura de ángulos, expresiones, distancias focales, iluminación y oclusiones. Si todas las fotos usan el mismo fondo, la red puede aprender una asociación accidental entre la identidad y ese fondo. Incluye casos difíciles sin perder un ancla de identidad coherente y utiliza únicamente material del que tengas derechos de entrenamiento.

Separación y contaminación de datos

El conjunto de validación no debe contener duplicados ni recortes casi idénticos a entrenamiento. Puedes usar hashes exactos para encontrar archivos idénticos y técnicas perceptuales para localizar casi duplicados, siempre con revisión humana. Divide por sesión u origen, no exclusivamente por archivo, porque diez capturas de una misma secuencia no son observaciones independientes. Una validación contaminada produce una percepción engañosa de consistencia.

Captions y atributos variables

Cada muestra debe registrar el concepto de identidad (si corresponde), pose, iluminación, expresión, ropa y condiciones especiales. Si quieres que la ropa cambie, no la conviertas accidentalmente en parte de la identidad. En un sistema LoRA, la variación del caption puede ayudar a separar los rasgos propios del personaje de detalles de la escena, pero el resultado también depende del modelo base, objetivo de entrenamiento, hiperparámetros y tamaño de muestra.

Rangos, sobreajuste y protocolo de evaluación

LoRA actualiza un número reducido de pesos mediante matrices de bajo rango, típicamente aproximando ΔW = B·A. No selecciones un adaptador solo por verse idéntico a sus fotos de entrenamiento: exígelo en poses y lugares no vistos. Compara varios checkpoints con el mismo lote de prompts de validación y registra: cambios de edad aparente, rasgos faciales, fondo aprendido, diversidad de expresiones y defectos. Si se repiten poses o vestuario, sospecha sobreajuste.

Caso de producción: Un personaje se reconoce perfectamente en estudio, pero en exteriores siempre vuelve a mostrar la misma silla. El entrenamiento probablemente acopló identidad y mobiliario; revisa diversidad de fondos, captions y muestras de validación independientes.

Laboratorio técnico del capítulo

  1. Diseña un esquema JSONL con file_name, text, origen, licencia y grupo_sesion.
  2. Propón 20 escenas de validación inéditas y criterios de aceptación antes de entrenar.
  3. Identifica qué fotografías nunca deberían compartirse en un entrenamiento remoto por licencias o privacidad.

Entregable: un documento de decisiones técnicas y evidencias; no basta con una imagen bonita.
Límite importante: El tutorial enseña el protocolo; no ejecuta entrenamiento de modelos en el navegador ni garantiza una identidad perfecta.
Capítulo 57 · A2E Master

Geometría 3D: cámaras calibradas, NeRF y Gaussian Splatting

Supera la generación de vistas independientes y comprende por qué se rompe la perspectiva.

Competencia al terminar: Entender la relación entre la escena tridimensional, la cámara y la imagen proyectada para planear recorridos con continuidad espacial.

La imagen es una proyección, no un mundo 3D

Una fotografía tiene dos dimensiones; una misma silueta 2D puede corresponder a distintas geometrías 3D. La cámara se caracteriza por parámetros intrínsecos (distancia focal, centro óptico y tamaño de imagen) y extrínsecos (rotación y traslación). Una forma abreviada de proyección de un punto X es x ≈ K·[R | t]·X, seguida de la normalización de coordenadas. Esto explica por qué cambiar el encuadre con un prompt no reproduce necesariamente un movimiento físico coherente.

NeRF frente a Gaussian Splatting

NeRF representa la escena mediante un campo neural de densidad y color condicionado por la posición y dirección de visualización. 3D Gaussian Splatting utiliza primitivas gaussianas optimizables con posición, orientación, escala, opacidad y apariencia, facilitando síntesis de nuevas vistas con renderizado eficiente. Son familias de técnicas para reconstruir y visualizar escenas, no botones mágicos para recuperar exactamente un cuerpo 3D desde una sola foto.

Calibración, cobertura y oclusiones

Una reconstrucción fiable se beneficia de capturas con solapamiento, perspectivas diversas y un sujeto razonablemente estable. Si el objeto está tapado, las vistas ausentes requieren inferencia y no pueden recuperarse de manera inequívoca. Para un personaje virtual debes distinguir reconstrucción de un objeto real de la generación coherente de un sujeto ficticio. Son problemas diferentes y necesitan pruebas diferentes.

Diseñar una trayectoria de cámara

Define posición inicial y final, distancia al personaje, altura de cámara, dirección de mirada, velocidad angular y puntos de control. Evita pedir en una sola frase “orbita 360°” sin datos visuales de la espalda si necesitas continuidad estricta. Comienza con un movimiento corto de 15–30° en una escena estática, valida proporciones y amplía gradualmente solo cuando la geometría lo permita.

Caso de producción: Una escena muestra a la influencer frente a una mesa, pero al “mover la cámara” la mesa cambia de lado. Es una discontinuidad de geometría y oclusión, no un error de color. Un render 3D controlado o referencias multiperspectiva ayudarían más que añadir adjetivos.

Laboratorio técnico del capítulo

  1. Dibuja un plano de cámara con coordenadas, objetivo y cinco puntos de trayectoria.
  2. Marca las partes del personaje o escenario que no están observadas desde la vista inicial.
  3. Compara qué harías con imagen a video, reconstrucción 3D y un renderizador tradicional.

Entregable: un documento de decisiones técnicas y evidencias; no basta con una imagen bonita.
Límite importante: La reconstrucción 3D avanzada requiere software y recursos específicos; el HTML explica el diseño sin hacer fotogrametría.
Capítulo 58 · A2E Master

Consistencia temporal en video: identidad, movimiento y continuidad entre tomas

El desafío ya no es una foto buena: son cientos de fotogramas coherentes.

Competencia al terminar: Crear un protocolo para revisar identidad, geometría, movimiento y continuidad narrativa en clips generados por IA.

Qué significa consistencia temporal

Dos cuadros pueden ser excelentes individualmente y aun así formar un video deficiente. Los problemas comunes son parpadeo de texturas, accesorios que aparecen o desaparecen, rostro que cambia, sombras incompatibles y saltos de movimiento. Debes distinguir consistencia local entre cuadros adyacentes de consistencia global entre planos separados en la historia. Una única puntuación de “calidad” no captura ambas.

Flujo óptico y seguimiento de características

El optical flow estima desplazamientos aparentes de píxeles entre dos imágenes. Si una región conserva su apariencia, una transformación por flujo puede servir como referencia para detectar diferencias de textura o saltos. Pero el flujo no resuelve oclusiones ni permite verificar identidad por sí solo. La investigación MotionPrompt utiliza orientación basada en flujo óptico para mejorar la coherencia del movimiento: es un enfoque de investigación, no una capacidad asegurada de A2E.

Keyframes y contratos de continuidad

Antes de generar, prepara un contrato por escena con: referencia de personaje, vestuario, relación espacial, dirección de luz, distancia de cámara y acción. Para un clip corto, define fotograma inicial, puntos de acción y estado final esperado. Para varios clips, registra qué elementos deben mantenerse entre el último cuadro del plano A y el primero del plano B. Nunca asumas que el modelo recuerda el plano anterior sin que el flujo le aporte ese contexto.

Métricas y revisión a escala

Inspecciona manualmente cuadros representativos, sobre todo cortes y cambios de iluminación. Puedes combinar puntuaciones de semejanza facial —con límites de sesgo y fiabilidad—, detección de objetos, consistencia de color, estadísticas de variación por cuadro y revisión de anomalías. Reporta el porcentaje de cuadros aceptados y la tasa de continuidad entre tomas definida por tu equipo; evita presentar una métrica como prueba definitiva de identidad.

Caso de producción: En un anuncio de 12 segundos el personaje cambia de collar a mitad de movimiento. Un flujo de revisión extrae cuadros en puntos de control, compara accesorios y corrige el segmento, en vez de regenerar toda la campaña sin diagnóstico.

Laboratorio técnico del capítulo

  1. Escribe una hoja de continuidad de tres planos con vestuario, cámara, luz y estado final.
  2. Selecciona al menos ocho instantes de revisión y define qué medir en cada uno.
  3. Registra causas de fallo y decide si debes regenerar el clip, dividir la acción o cambiar la referencia.

Entregable: un documento de decisiones técnicas y evidencias; no basta con una imagen bonita.
Límite importante: Los modelos de video comerciales difieren en controles de fotogramas inicial/final, duración y acceso a referencias; verifica qué ofrece tu plan.
Capítulo 59 · A2E Master

Optimización de inferencia: VRAM, cuantización y latencia sin confundir calidad

Diseña sistemas que funcionen en tu hardware y presupuesto.

Competencia al terminar: Elegir estrategias de memoria y aceleración basadas en mediciones de consumo, latencia y calidad visual, no en cifras promocionales.

Modelo en disco no equivale a VRAM necesaria

El peso almacenado es solo una parte del consumo. Durante la inferencia también existen activaciones, representaciones intermedias, buffers, componentes de texto, decodificación de imágenes y memoria del runtime. El valor crece con resolución, batch, arquitectura y precisión. Por eso una descarga de pocos gigabytes no garantiza ejecución en una GPU integrada ni predice el tiempo de render de una aplicación.

Cuantización y precisión

Cuantizar reduce la precisión con que se almacenan o procesan determinados pesos, por ejemplo usando menos bits que una representación de referencia. Esto puede disminuir memoria y facilitar despliegue, pero introduce errores numéricos y los beneficios reales dependen del backend y del hardware. Evalúa retratos, manos, texto dentro de imágenes y composición compleja; los errores no siempre aparecen en escenas sencillas. No asumas que una reducción de bits genera una aceleración proporcional.

Offloading, slicing y compilación

CPU offload mueve componentes fuera de la GPU y los trae cuando se necesitan; reduce demanda de VRAM a cambio de transferencias y, frecuentemente, más latencia. La ejecución por bloques o la fragmentación de operaciones puede disminuir picos de memoria. torch.compile y otras optimizaciones dependen del entorno y pueden introducir tiempo inicial de compilación. No mezcles cinco optimizaciones a la vez: mide cada cambio y documenta compatibilidades.

Rendimiento como decisión de ingeniería

Define una tabla reproducible con: modelo exacto, versión, hardware, resolución, número de pasos, batch, dtype, tiempo hasta primera imagen, tiempo total, memoria pico, tasa de errores y evaluación humana de calidad. Mide varias corridas, separando el calentamiento de la inferencia estable. Para un flujo comercial, el KPI útil no es solo “segundos por imagen” sino costo y tiempo por pieza aprobada.

Caso de producción: En una PC con gráfica integrada, el modelo completo no cabe en memoria acelerada. En lugar de insistir en “más calidad”, evalúas primero cuantización compatible, CPU offload y ejecución remota, comparando costos, privacidad y tiempos.

Laboratorio técnico del capítulo

  1. Diseña una matriz con configuración base y cuatro optimizaciones probadas por separado.
  2. Especifica cómo medirás memoria pico, latencia y calidad sin cambiar de prompt.
  3. Decide entre ejecución local y nube justificando privacidad, presupuesto y disponibilidad real.

Entregable: un documento de decisiones técnicas y evidencias; no basta con una imagen bonita.
Límite importante: No prometas generar imágenes de alta resolución con JavaScript puro: esta página es educativa; las técnicas requieren un entorno de inferencia adecuado.
Capítulo 60 · A2E Master

Arquitectura de un sistema generativo profesional: colas, trazabilidad y recuperación

De experimentos aislados a una infraestructura auditable para proyectos de IA.

Competencia al terminar: Especificar un sistema de producción de imágenes y videos confiable, con tareas reintentables, versionado, observabilidad y criterios de salida.

Separar interfaz, orquestación y motor

Una arquitectura mantenible distingue cuatro capas: interfaz (captura de especificaciones), orquestador (coordina etapas), motor (genera imágenes o videos) y almacenamiento (archivos y metadatos). AppInitDev, alojado como sitio estático en Hostinger, puede ofrecer el panel, constructor y exportación local. La inferencia real de modelos grandes necesitará un proceso externo o servicio compatible; no implica que debas publicar claves de API en JavaScript.

Tareas idempotentes y colas

Cada solicitud debe tener un identificador único, referencia a la configuración y una clave de idempotencia. Una tarea pasa por estados como queued → running → validating → approved/rejected → published. Si se corta la conexión, el cliente consulta el estado en vez de enviar el mismo trabajo muchas veces. Los reintentos necesitan límite, retraso progresivo y tratamiento distinto de errores temporales y errores definitivos de validación.

Proveniencia y versiones reproducibles

Registra id del personaje, versión del prompt, imagen de referencia, modelo exacto cuando sea conocido, semilla si la admite, configuración, fecha, licencia, resultado, revisión humana y destino de publicación. Un hash SHA-256 permite comprobar que los bytes de un archivo no cambiaron; no demuestra que una imagen sea verdadera o consentida. Separa los hashes de la información de derechos y de la revisión editorial.

Calidad antes de publicar y respuesta a incidentes

Una salida debe superar validaciones técnicas (tipo, tamaño, proporción), visuales (anatomía, identidad y continuidad), contractuales (uso autorizado del material), y editoriales (declaración de IA cuando corresponda). Define procesos de reversión, retiro de material, eliminación de datos y revisión ante reclamos. Para videos y material adulto legal, la verificación de derechos, edad y consentimiento requiere medidas adecuadas: un checkbox de HTML por sí solo no equivale a verificación efectiva.

Qué automatizar y qué no

Automatiza registros, conversiones, colas y reportes medibles; conserva revisión humana para aceptación de identidad, decisiones legales sensibles y aprobación de publicación. Instrumenta indicadores como tasa de trabajo fallido, tiempo medio por etapa, costo por resultado aprobado y motivos de rechazo. En una plataforma externa, las integraciones dependen de APIs y permisos realmente disponibles: no inventes endpoints ni capacidades.

Caso de producción: Tu estudio necesita 50 variaciones de una misma campaña. En lugar de iniciar 50 acciones manuales sin control, una cola planifica lotes, registra cada configuración, valida formatos y envía para aprobación solo los resultados que completaron todas las etapas.

Laboratorio técnico del capítulo

  1. Diseña un JSON de trabajo con job_id, referencias, modelo, configuración, estado, errores y revisión.
  2. Dibuja un diagrama de recuperación ante fallo de red, límite de créditos y archivo corrupto.
  3. Redacta un plan de publicación que requiera aprobación humana y contenga un proceso de retirada.

Entregable: un documento de decisiones técnicas y evidencias; no basta con una imagen bonita.

Límite importante: Un flujo exportado en JSON por el tutorial no es un backend real ni una integración directa con A2E. No expongas tokens privados en el navegador.

Proyecto final Master — Una producción visual reproducible

Elige un personaje ficticio propio y plantea una producción de tres fotografías y dos clips. Justifica arquitectura, condiciones, validación del dataset, restricciones geométricas, continuidad entre escenas, elección de hardware y diseño de la cola de producción. Entrega una hoja de decisión técnica, diez observaciones de calidad y un plan de recuperación ante fallo. Este ejercicio no requiere entrenar modelos comerciales ni disponer de una GPU dedicada para documentar correctamente el flujo.

Parte 4: Pro-Experto Plus · Parte 3: Experto · Manual básico · Galería y ejemplos

Guía educativa independiente de A2E. Las funciones y modelos disponibles en A2E pueden cambiar; no se afirman integraciones o capacidades que el proveedor no documenta.

Banco visual unificado

Referencias visuales compartidas

Aunque este nivel es más técnico, ahora incorpora referencias del proyecto para mantener continuidad de estilo con las demás clases y no verse aislado.

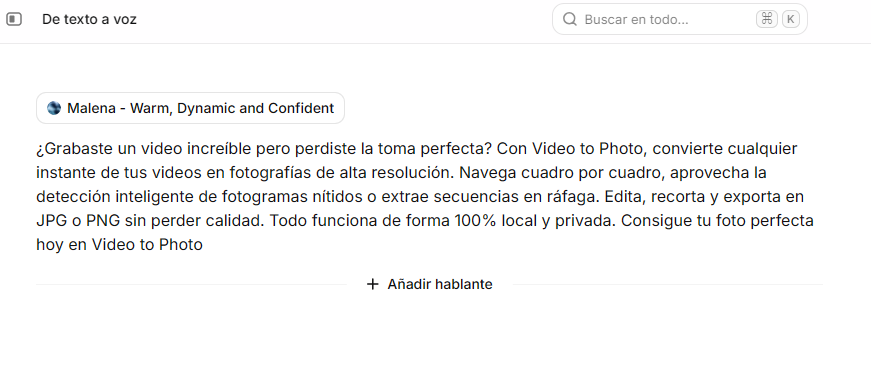
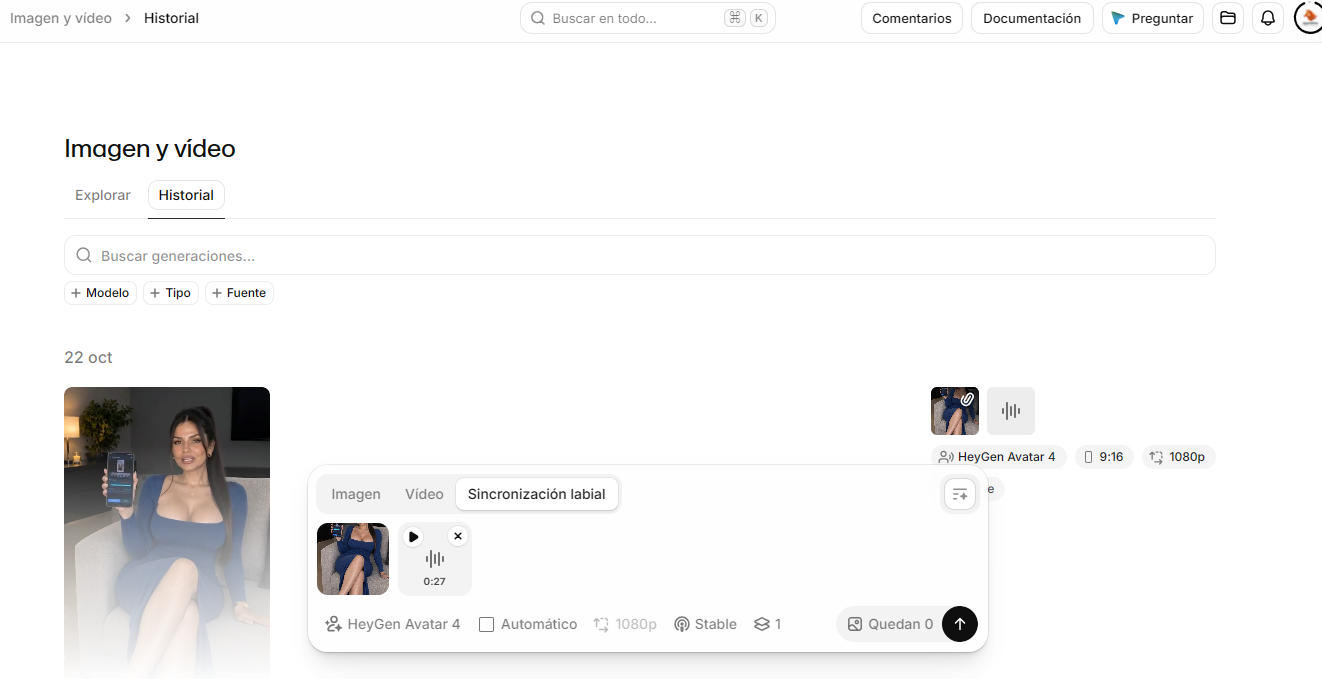
Lipsync y voz
Lipsync y vozReferencia técnica para sincronización visual y narrativa.
Resultado lipsync
Resultado lipsyncComparación entre entrada y salida de voz.
Modelo de voz
Modelo de vozApoyo conceptual para pipelines multimodales.
Fotograma base
Fotograma baseReferencia para consistencia temporal en video.
Tabla de apoyo
Tabla de apoyoEjemplo de recurso secundario dentro del ecosistema.
Trazo y estructura
Trazo y estructuraIlustra control geométrico y guiado.
Nota de consistencia: esta sección utiliza imágenes adicionales de influencer_consistencia e influenser para que todas las páginas del curso compartan el mismo lenguaje visual, tarjetas y presentación de ejemplos.